เมื่อ AI เรียนรู้จากข้อมูลที่สร้างขึ้นโดย AI รุ่นก่อนหน้าอย่างต่อเนื่อง ความรู้เฉพาะทางด้านวัฒนธรรมที่ถ่ายทอดผ่านภาษา โดยเฉพาะภาษาที่มีทรัพยากรข้อมูลจำกัดอย่างภาษาพม่า จะยังคงอยู่ได้มากน้อยเพียงใด?
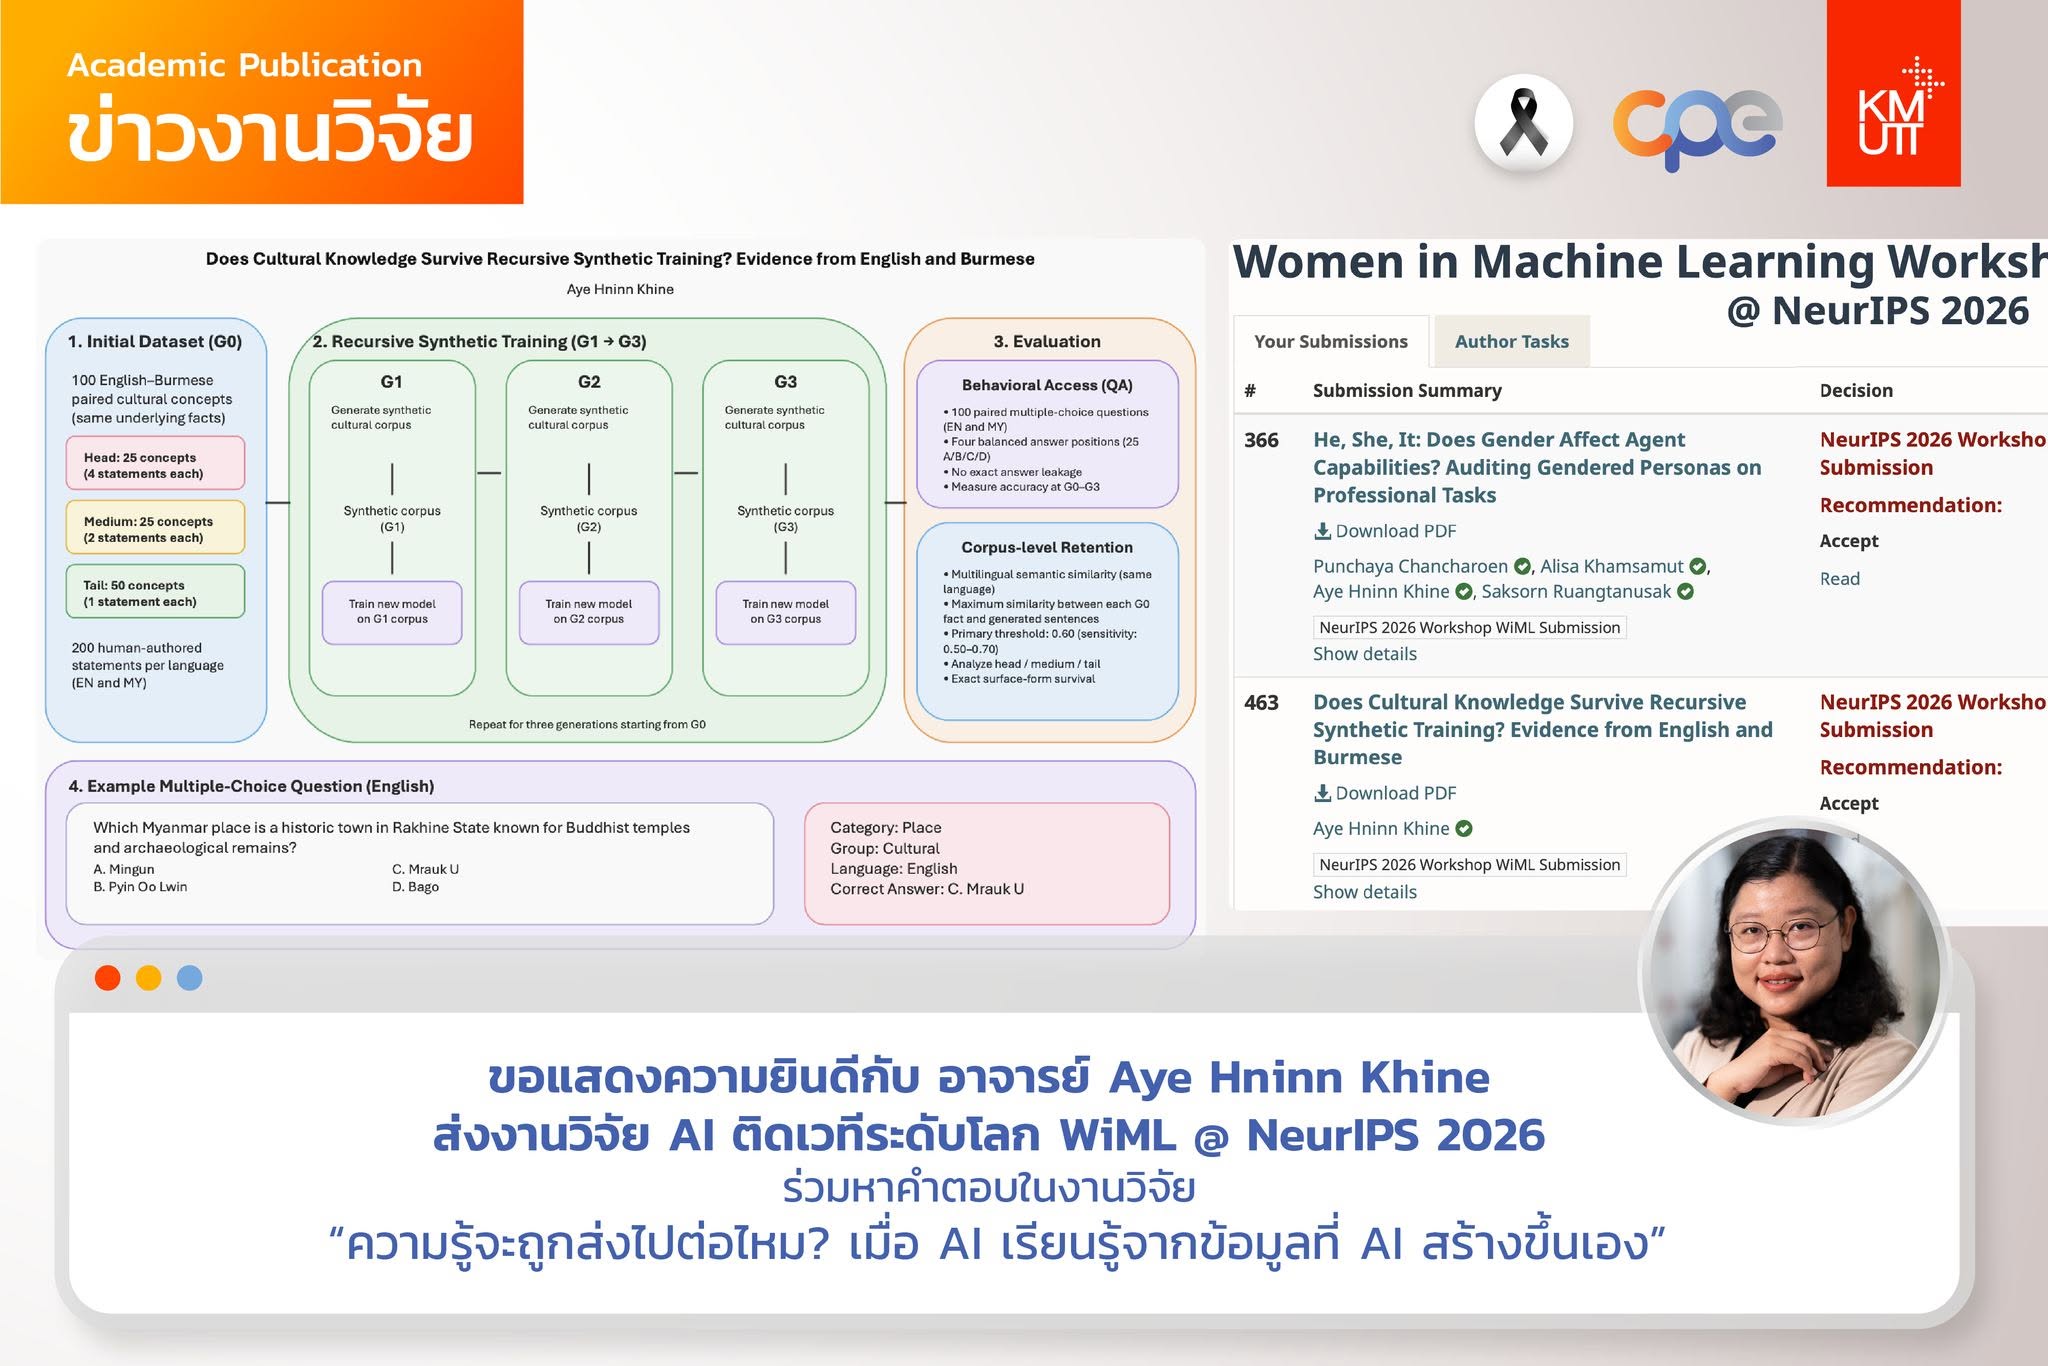
ดร. Aye Hninn Khine จากภาควิชาวิศวกรรมคอมพิวเตอร์ มหาวิทยาลัยเทคโนโลยีพระจอมเกล้าธนบุรี (มจธ.) มีผลงานวิจัยเรื่อง “Does Cultural Knowledge Survive Recursive Synthetic Training? Evidence from English and Burmese” ได้รับการตอบรับให้นำเสนอในงาน Women in Machine Learning Workshop (WiML) 2026 ซึ่งจัดร่วมกับ NeurIPS 2026 เวทีประชุมวิชาการด้านการเรียนรู้ของเครื่องระดับนานาชาติ
ศึกษาการถ่ายทอดความรู้ทางวัฒนธรรมผ่านข้อมูลสังเคราะห์
งานวิจัยนี้ศึกษาว่า เมื่อโมเดล AI เรียนรู้จากข้อมูลสังเคราะห์ที่สร้างโดยโมเดลรุ่นก่อนหน้าอย่างต่อเนื่อง ความรู้ทางวัฒนธรรมจะเปลี่ยนแปลงหรือสูญหายไปอย่างไร โดยเปรียบเทียบข้อมูลภาษาอังกฤษและภาษาพม่า
ทีมวิจัยเริ่มต้นจากชุดข้อมูลความรู้ทางวัฒนธรรมจำนวน 100 รายการ ซึ่งจับคู่เนื้อหาในภาษาอังกฤษและภาษาพม่าเป็นข้อมูลตั้งต้น (G0) จากนั้นให้โมเดลสร้างข้อมูลชุดใหม่ (G1) และใช้ข้อมูลดังกล่าวฝึกโมเดลรุ่นถัดไปเพื่อสร้างข้อมูลรุ่น G2 และ G3 ตามลำดับ โดยแต่ละรุ่นอาศัยข้อมูลจากรุ่นก่อนหน้า แทนการเข้าถึงข้อเท็จจริงต้นฉบับโดยตรง
การทดลองประเมินผลในสองด้าน ได้แก่ ความแม่นยำในการตอบคำถามเกี่ยวกับความรู้ทางวัฒนธรรม และความคล้ายคลึงเชิงความหมายระหว่างข้อความที่สร้างขึ้นกับข้อเท็จจริงต้นฉบับ
ผลการวิจัย: ข้อความยังคล้ายต้นฉบับ แต่ความแม่นยำในการตอบคำถามลดลง
ผลการทดลองแสดงให้เห็นว่า ความแม่นยำในการตอบคำถามลดลงทั้งสองภาษา โดยภาษาอังกฤษลดลงจาก 61% เหลือ 54% ขณะที่ภาษาพม่าลดลงจาก 48% เหลือ 44%
อย่างไรก็ตาม เมื่อพิจารณาความคล้ายคลึงเชิงความหมายในรุ่นสุดท้าย พบว่าข้อมูลภาษาพม่ามีความคล้ายคลึงกับข้อเท็จจริงต้นฉบับ 73% เทียบกับ 60% สำหรับภาษาอังกฤษ
ผลลัพธ์นี้สะท้อนให้เห็นว่า ความคล้ายคลึงของข้อความกับข้อมูลต้นฉบับไม่ได้หมายความว่าโมเดลจะยังสามารถนำความรู้นั้นมาใช้ตอบคำถามได้อย่างแม่นยำเสมอไป การประเมินคุณภาพของข้อมูลสังเคราะห์จึงจำเป็นต้องพิจารณาทั้งลักษณะของเนื้อหาและความสามารถของโมเดลในการใช้ความรู้ดังกล่าว
ความสำคัญต่อการพัฒนา AI สำหรับภาษาที่มีทรัพยากรจำกัด
งานวิจัยนี้นำเสนอประเด็นสำคัญสำหรับการพัฒนาโมเดล AI ที่ต้องพึ่งพาข้อมูลสังเคราะห์มากขึ้น โดยเฉพาะในภาษาที่มีทรัพยากรข้อมูลจำกัด ซึ่งความรู้เฉพาะทางและบริบททางวัฒนธรรมอาจมีข้อมูลสำหรับฝึกโมเดลไม่มากนัก
ข้อค้นพบดังกล่าวชี้ให้เห็นถึงความจำเป็นในการออกแบบวิธีประเมินที่ไม่ได้พิจารณาเพียงว่าข้อความที่สร้างขึ้นยังคงคล้ายกับข้อมูลต้นฉบับหรือไม่ แต่ต้องตรวจสอบด้วยว่าโมเดลยังคงเรียนรู้และนำความรู้นั้นไปใช้งานได้จริงเพียงใด
ภาควิชาวิศวกรรมคอมพิวเตอร์ มจธ. ขอแสดงความยินดีกับ ดร. Aye Hninn Khine สำหรับผลงานวิจัยที่ได้รับการตอบรับให้นำเสนอในเวทีวิชาการระดับนานาชาติ และขอสนับสนุนการสร้างองค์ความรู้ใหม่ด้านปัญญาประดิษฐ์ที่ช่วยขยายความเข้าใจเกี่ยวกับคุณภาพข้อมูล การเรียนรู้ของโมเดล และความหลากหลายทางภาษาและวัฒนธรรมต่อไป